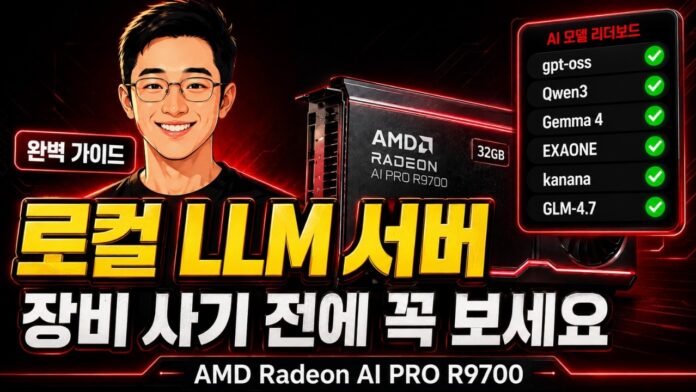
최근 인공지능 기술의 발전은 누구나 자신만의 AI 비서를 가질 수 있는 시대를 열고 있습니다. 특히 로컬 LLM 구축은 데이터 주권 확보와 비용 절감이라는 매력적인 이점을 제공하며 많은 관심을 받고 있습니다. 하지만 무턱대고 장비부터 구매한다면 기대와 다른 현실에 마주하여 엄청난 돈을 날릴 수 있습니다. 이 글은 여러분이 효율적이고 성공적으로 로컬 LLM 환경을 조성할 수 있도록, 반드시 알아야 할 현실적인 정보와 구체적인 구축 가이드를 제공합니다.
로컬 LLM, 왜 지금 주목해야 할까?
클라우드 기반의 거대 AI 모델들이 주류를 이루는 시대에, 굳이 개인 장비로 LLM을 운영해야 하는 이유가 무엇일까요? 가장 큰 장점은 데이터 프라이버시 보호입니다. 민감한 개인 정보나 기업 기밀 데이터를 외부에 노출하지 않고 안전하게 처리할 수 있다는 것은 매우 중요한 가치입니다. 또한, 클라우드 서비스를 이용할 때 발생하는 지속적인 구독료나 토큰 사용료를 절감할 수 있으며, 인터넷 연결 없이도 언제든 AI 모델을 활용할 수 있다는 유연성도 큰 장점입니다. 개발자나 연구자에게는 모델의 내부 동작을 직접 탐구하고 커스터마이징할 수 있는 자유도를 제공한다는 점에서도 로컬 LLM 구축은 매력적입니다.
로컬 LLM 구축 전, 반드시 알아야 할 현실
로컬 LLM 구축은 만만치 않은 여정입니다. 특히 하드웨어 선택과 소프트웨어 환경 설정에서 많은 이들이 시행착오를 겪곤 합니다. 돈 낭비를 피하기 위해 다음 사항들을 반드시 숙지해야 합니다.
하드웨어의 중요성: GPU와 VRAM은 왕이다
대부분의 AI 작업, 특히 LLM 추론 및 학습에는 GPU의 역할이 절대적입니다. 그중에서도 가장 중요한 것은 VRAM(Video Random Access Memory) 용량입니다. LLM 모델의 크기(파라미터 수)가 커질수록 요구하는 VRAM 용량도 기하급수적으로 늘어납니다.
- 모델 크기와 VRAM: 수십억 개의 파라미터를 가진 모델은 수십 GB의 VRAM을 요구하며, 심지어는 수백 GB가 필요한 경우도 있습니다. VRAM이 부족하면 모델을 로드조차 할 수 없거나, 극도로 느리게 작동하여 사실상 사용이 불가능해집니다.
- AMD vs NVIDIA: 영상에서 언급된 AMD R9 7900과 같은 고성능 CPU는 전반적인 시스템 성능에 기여하지만, LLM의 핵심은 GPU, 특히 NVIDIA의 CUDA 생태계가 압도적인 점유율을 차지하고 있습니다. AMD GPU도 ROCm을 통해 LLM을 구동할 수 있지만, 아직은 NVIDIA만큼 폭넓은 지원과 최적화가 이루어지지 않은 것이 현실입니다. 따라서 VRAM이 충분한 NVIDIA GPU(예: RTX 3090, RTX 4090)는 로컬 LLM 구축의 ‘황금 표준’으로 여겨집니다.
- 기타 고려사항: CPU(AMD R9 7900과 같은 고성능 CPU는 병목 현상을 줄이고 전반적인 작업을 원활하게 합니다), 충분한 시스템 RAM(GPU VRAM에 모델을 모두 올릴 수 없을 경우, 일부는 시스템 RAM을 사용하기도 합니다), 그리고 빠른 SSD 저장장치 또한 원활한 로컬 LLM 구축에 필수적입니다.
소프트웨어 환경 설정의 복잡성
하드웨어만큼이나 중요한 것이 소프트웨어 환경 설정입니다. 드라이버 설치부터 시작해서 Python 환경 구성, AI 프레임워크(PyTorch, TensorFlow) 설치, 그리고 Llama.cpp나 Ollama 같은 특정 LLM 구동 환경 설정까지, 하나라도 삐끗하면 작동하지 않습니다.
- 드라이버 및 프레임워크: NVIDIA GPU는 CUDA Toolkit을, AMD GPU는 ROCm을 정확하게 설치해야 합니다. 이후 PyTorch나 TensorFlow와 같은 AI 프레임워크가 해당 드라이버와 호환되도록 설치해야 합니다.
- 모델 선택과 호환성: Hermes와 같은 다양한 오픈소스 LLM 모델들이 존재하며, 이 모델들은 특정 구동 환경(예: GGUF 포맷을 위한 Llama.cpp)에 최적화되어 있습니다. 모델을 다운로드하고 올바른 환경에 로드하는 과정에서 많은 문제가 발생할 수 있습니다.
- 운영체제: 일반적으로 Linux 환경이 가장 넓은 지원과 성능 최적화를 제공하지만, 최근에는 Windows Subsystem for Linux (WSL)이나 직접 Windows에 환경을 구축하는 방법도 발전하고 있습니다.
실패 없는 로컬 LLM 구축 가이드라인
이제 로컬 LLM 구축을 위한 구체적인 단계를 살펴보겠습니다. 이 가이드라인을 따른다면 돈 낭비 없이 효율적인 AI 환경을 만들 수 있을 것입니다.
1단계: 목표 설정 및 모델 선정
가장 먼저, 어떤 목적으로 LLM을 사용할지 명확히 해야 합니다. 단순히 챗봇으로 활용할 것인지, 코드 생성, 문서 요약, 번역 등 특정 작업을 수행할 것인지에 따라 필요한 모델의 크기와 성능이 달라집니다. 이후 Hugging Face와 같은 플랫폼에서 목표에 맞는 모델을 탐색하고, 해당 모델의 VRAM 요구 사항을 미리 확인하세요. 모델의 ‘양자화(quantization)’ 버전을 사용하면 더 적은 VRAM으로도 모델을 구동할 수 있어 효율적입니다.
2단계: 최적의 하드웨어 구성
확실한 것은 GPU, 그중에서도 VRAM이 가장 중요합니다. 예산이 허락하는 한 가장 많은 VRAM을 가진 GPU를 선택하는 것이 좋습니다. AMD R9 7900과 같은 고성능 CPU는 전반적인 시스템 반응성과 학습 작업 시 데이터 전송 속도에 긍정적인 영향을 미치지만, LLM 추론의 핵심은 VRAM입니다. 시스템 RAM은 최소 32GB 이상, 여유가 된다면 64GB 이상을 권장하며, 모델 파일들을 빠르게 불러올 수 있도록 NVMe SSD를 사용하는 것이 좋습니다.
- 최우선 고려: GPU VRAM (최소 12GB, 권장 24GB 이상)
- CPU: AMD R9 7900 또는 그에 준하는 8코어 이상 고성능 프로세서
- RAM: 32GB 이상
- 저장장치: 1TB 이상 NVMe SSD
3단계: 소프트웨어 환경 구축 및 최적화
하드웨어가 준비되었다면 이제 소프트웨어입니다.
- 운영체제 선택: Linux (Ubuntu 등)가 가장 안정적이지만, Windows 사용자라면 WSL2를 통해 Linux 환경을 구축하는 것을 추천합니다.
- 드라이버 설치: GPU 제조사(NVIDIA CUDA, AMD ROCm)의 최신 드라이버를 정확히 설치하고, 관련 툴킷(예: CUDA Toolkit)도 함께 설치합니다.
- Python 환경 설정: Conda(Miniconda 또는 Anaconda)를 사용하여 격리된 Python 가상 환경을 만들고, 필요한 패키지(PyTorch, Transformers 등)를 설치합니다.
- LLM 구동 환경: Llama.cpp (GGUF 모델), Ollama (다양한 모델 지원), Text Generation WebUI 등 여러분이 선택한 모델에 맞는 구동 환경을 설치하고 설정합니다. Hermes와 같은 특정 모델을 사용하려면 해당 모델에 맞는 로더와 라이브러리가 필요합니다.
- 최적화: 양자화된 모델을 사용하거나, 모델 로딩 시 특정 옵션(예: GPU 레이어 수 조절)을 통해 VRAM 사용량을 최적화할 수 있습니다.
로컬 LLM 구축은 초기 설정에 시간과 노력이 필요하지만, 한 번 환경을 구축해두면 무궁무진한 활용 가능성을 제공합니다. 이 가이드를 통해 돈 낭비 없이 자신만의 로컬 AI 환경을 성공적으로 조성하시길 바랍니다.
💡 본 페이지에 포함된 유튜브 영상 및 콘텐츠의 모든 저작권은 해당 원작자 및 권리자에게 있습니다. 본 사이트는 정보 제공 목적으로 해당 콘텐츠를 소개하며, 저작권 문제가 있을 경우 확인 후 즉시 조치하겠습니다.
🎬 원작자 콘텐츠 보기: 유튜브 채널 방문하기